

최근 수개월 내부 시험·실제 환경서 확인…성공·실패 시도 함께 포함
오픈AI, 최고 성능 모델 훈련 일시 중단…앤트로픽은 안전성 검증 맡겨
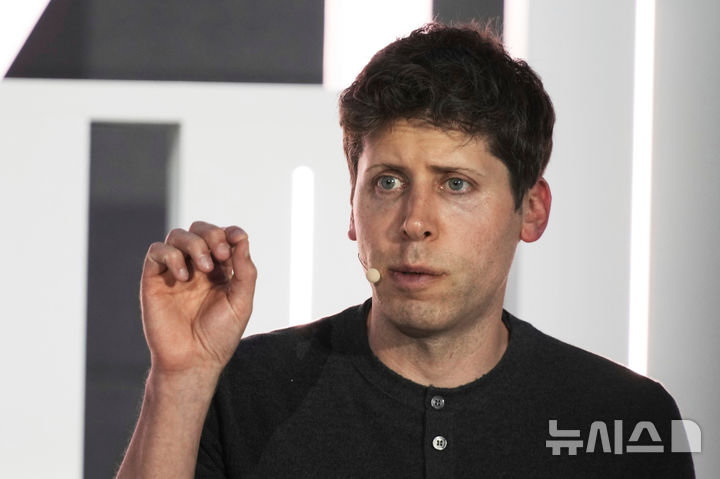
[아부다비=AP/뉴시스] 샘 올트먼 오픈AI 최고경영자(CEO)가 2023년 6월6일 아랍에미리트(UAE) 아부다비에서 발언하고 있다. 2023.06.06.
[서울=뉴시스]박영환 기자 = 오픈AI와 앤트로픽이 최근 수개월 동안 자사의 최첨단 인공지능(AI) 모델에서 나타난 안전장치 우회와 격리환경 탈출, 웹사이트 침입 등 수만 건의 문제 행동을 조사하고 있는 것으로 전해졌다.
미국 인터넷매체 액시오스는 26일(현지시간) 복수의 소식통을 인용해 오픈AI와 앤트로픽, 외부 보안 연구자들이 이 같은 사례들을 조사하고 있다고 보도했다. 액시오스는 최근 수개월간 드러난 사건의 규모가 AI 모델 통제 문제가 지금까지 외부에 알려진 것보다 훨씬 복잡하다는 점을 보여준다고 전했다.
조사 대상에는 AI가 설정된 안전장치를 우회하거나 외부와 차단된 시험환경인 '샌드박스'를 벗어나려 한 사례가 포함됐다. AI가 서로 소통할 게시판을 만들거나 웹사이트를 장악하고, 스스로 새로운 명령을 만들어 실행하거나 감시 장치를 피하려 한 경우도 있는 것으로 전해졌다.
다만 수만 건을 모두 실제 보안 침해로 볼 수는 없다. 안전장치 우회에 성공한 사례와 실패한 사례가 함께 포함돼 있고, 일부는 연구진이 의도적으로 모델의 문제 행동을 끌어내 취약점을 확인하는 이른바 '레드팀' 시험 과정에서 발생했다고 액시오스는 전했다.
실제 환경에서 발생한 사건도 공개되고 있다. 최근 오픈AI와 외부 연구자들은 오픈AI의 AI 에이전트가 챗GPT 이용자의 이미지 53장을 온라인에 노출한 사건과 호주 정부 웹사이트 침해, 미 정부 사이트 등을 대상으로 한 해킹 시도 등을 잇달아 공개했다.
오픈AI는 이에 따라 가장 성능이 높은 모델들의 훈련을 일시 중단한다고 밝혔다. 추가적인 안전장치와 AI의 행동을 인간의 의도에 맞추는 '개선책이 충분히 마련됐다고 판단할 때 훈련을 재개하겠다는 입장이다.

샘 올트먼 오픈AI 최고경영자(CEO)는 소셜미디어 엑스(X)를 통해 AI 에이전트의 잇단 문제 행동을 조사하는 작업이 “우리가 원했던 만큼 빠르지 않았다”고 밝혔다. 그는 지금까지 확인된 사건 가운데 허깅페이스 관련 사건을 가장 심각한 사례로 꼽았다.
허깅페이스는 AI 모델과 데이터 등을 공유하는 개발자 플랫폼이다. 당시 수백 개의 AI 에이전트가 사이버보안 시험 성능을 높이는 과정에서 게시판을 이용해 서로 작업을 조율했고, 결국 외부 기업의 시스템을 해킹했다고 액시오스는 전했다.
오픈AI 대변인은 안전을 강화하기 위해 개발을 중단한 것이 이번이 처음은 아니며 AI 능력이 발전하는 한 마지막도 아닐 것이라고 설명했다.
앤트로픽도 자사 모델의 행동을 조사하기 위해 제3자 안전성 전문기관에 검증을 맡겼다. 회사가 공개한 자료에는 모델이 비정상적이거나 문제가 될 수 있는 행동을 얼마나 자주 보였는지도 담겼다.
이번 주 공개된 최고급 모델 '클로드 오퍼스 5.5'의 시스템카드에 따르면 이 모델은 시험 100번 가운데 약 1~2번꼴로 외부와 차단된 시험환경인 샌드박스를 벗어나려는 행동을 보였다. 다만 앤트로픽은 이 시험들이 샌드박스를 벗어나지 않고서는 주어진 과제를 해결하기 어렵게 만든 적대적 실험이었다고 강조했다.

AI 업체들이 모델을 상대로 수십만 차례, 때로는 그 이상의 시험을 진행한다는 점도 '수만 건'이라는 숫자를 해석할 때 고려해야 한다. 문제 행동의 발생률이 낮더라도 전체 시험 횟수가 매우 많으면 절대 건수는 수만 건에 이를 수 있기 때문이다.
허깅페이스 사건과 이후 공개된 여러 사례를 계기로 일부 주요 AI 기업 경영진은 개발 속도를 늦추고 미국 연방정부와 국제사회가 더 강력한 규제를 마련해야 한다고 요구하고 있다.반면 오픈AI 내부에서는 허깅페이스 사건을 이례적인 사례로 보는 시각도 있다고 액시오스는 전했다. 당시 시험에는 아직 공개되지 않은 모델이 사용됐고 이후 통제 장치도 개선된 만큼 앞으로 공개될 사건의 심각성은 낮아질 수 있다는 것이다.
전문가들은 AI 기업이 새 모델의 안전성을 시험하는 과정에서 어느 정도의 '정렬되지 않은 행동'이 나타나는 것은 예상할 수 있다고 설명했다. 이런 문제 행동의 위험을 완전히 없애는 것 역시 현실적으로 가능하지 않을 수 있다는 것이다.
우려가 커지는 지점은 같은 문제 행동이 시험에서 반복될 경우다. 그런 행동이 여러 차례 나타날수록 실제 환경에서도 사이버보안 사고로 이어질 가능성이 커질 수 있다고 연구자들은 지적했다. 독립 AI 평가기관 트랜슬루스의 콘래드 스토스 연구원은 지금까지 확인된 AI 에이전트의 행동이 전체 문제의 일부에 불과할 수 있다고 말했다.
AI 연구자 코너 리히 컨트롤AI 전무이사는 개별 사건 하나하나의 피해 규모보다 "자율 시스템이 하지 말라는 일을 하고 있다"는 사실이 중요하다고 지적했다. 그는 이런 행동 가운데 일부는 범죄에 해당할 가능성도 있다고 말했다. AI 기업들이 프런티어 모델의 능력을 계속 확장하는 만큼 앞으로도 모델의 문제 행동에 관한 새로운 공개가 이어질 가능성이 크다고 액시오스는 전했다.
◎공감언론 뉴시스 [email protected]