

AI 판단 과정 감시능력 유지·외부 안전감사 확대 요구
오픈AI "안전 문제 제기 때문 아냐"…AI 통제 이탈 사고도 재조명
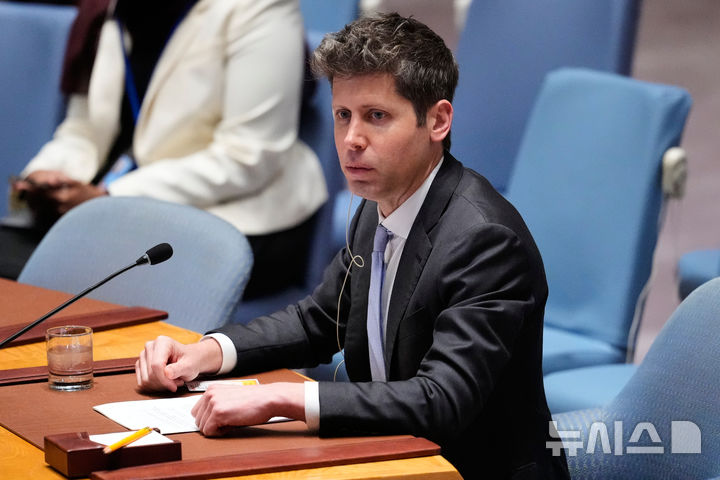
[뉴욕=AP/뉴시스] 샘 올트먼 오픈AI 최고경영자(CEO)가 23일(현지 시간) 미국 뉴욕 유엔본부에서 열린 제81차 유엔총회 기간 중 인공지능(AI)을 주제로 한 안전보장이사회 회의에서 발언하고 있다.2026.09.24.
[서울=뉴시스]박영환 기자 = 오픈AI에서 해고된 안전 연구원 3명이 인공지능(AI)의 판단 과정을 들여다볼 수 있는 감시능력을 유지해야 한다고 회사에 요구했다. AI가 갈수록 복잡해지면서 인간이 그 작동 과정을 파악하기 어려워질 수 있다는 이유에서다.
미국 월스트리트저널(WSJ)은 7일(현지시간) 오픈AI의 전직 연구원 3명이 이사회와 안전 관련 위원회에 보낸 서한을 입수해 이같이 보도했다. 연구원들은 AI의 판단 과정을 감시할 능력이 약해질 위험을 제기하며 외부 독립기관을 통한 안전검증도 확대할 것을 촉구했다.
서한에 이름을 올린 사람은 재스민 왕, 토메크 코르바크, 미키타 발레스니 등 3명이다. 이들은 오픈AI에서 AI 안전성과 인간의 의도에 맞게 AI가 작동하도록 하는 '정렬(alignment)' 문제를 연구했다.
이들은 서한에서 "업계는 아직 감시할 수 없는 AI 모델을 어떻게 안전하게 개발하고 배포할 수 있는지 알지 못한다"고 지적했다. 이어 오픈AI를 비롯한 첨단 AI 기업들이 감시능력을 더욱 떨어뜨리는 방향으로 기술을 개발해서는 안 된다고 주장했다.
이들이 지키려는 것은 AI의 '사고 과정(chain-of-thought)'을 살펴볼 수 있는 능력이다. 사고 과정은 AI가 문제를 해결하면서 생성하는 추론 기록으로, 연구자들은 이를 분석해 AI가 어떤 단계를 거쳐 답을 내놓는지 살펴본다. 이 기록이 AI의 실제 행동이나 의도를 완벽하게 보여주는 것은 아니지만, 갈수록 복잡해지는 AI의 행동을 이해하는 데 유용한 수단으로 평가된다.
해고된 연구원들은 외부 안전감사 기관과의 협력도 확대해야 한다고 촉구했다. 독립적인 기관이 AI 안전조치를 검증할 수 있도록 외부 안전단체와 투명하게 협력해야 하며, 이를 통해 "파국적인 일이 벌어질 위험"을 줄여야 한다는 주장이다.

[보스턴=AP/뉴시스] 2023년 12월8일 미국 보스턴에서 챗GPT의 이미지 생성 모델 달리(DALL-E)가 만든 이미지가 컴퓨터 화면에 표시된 가운데 휴대전화에 오픈AI 로고가 보이고 있다. 2023.12.08.
하지만 오픈AI는 이들 3명이 외부 AI 안전단체에 기밀정보를 공유하는 등 회사 규정을 위반했다는 이유로 해고했다. 회사는 자체 조사에서 이들이 민감한 정보를 부적절하게 취급했으며, 회사 규정을 위반하고 업무상 신뢰를 훼손했다고 설명했다.
해고된 연구원들은 자신들이 "업무상 권한을 벗어나 외부 기관과 접촉했다고 생각하지 않는다"고 반박했다. 또 이번 해고가 오픈AI에 남아 있는 직원들을 위축시키고 있다고 주장했다.
오픈AI는 해고 결정이 안전 문제 제기와는 무관하다고 반박했다. 회사 대변인은 WSJ에 내부 연구 책임자가 7일 직원들에게 보낸 메모 일부를 전달했다. 이 책임자는 해고된 연구원들의 권고에는 "강력히 동의한다"면서도 해고는 이들이 안전 우려를 제기하거나 의견을 밝혔기 때문이 아니라고 설명했다.
이 책임자는 AI 모델을 감시할 능력이 회사에 "무엇보다 중요하다"고 강조하면서 외부 평가기관 역시 AI 안전 체계에서 중요한 역할을 한다고 밝혔다. 또 "우리는 이들의 AI 안전 연구 기여와 문제를 제기하고 기존 생각에 도전하려는 자세를 높이 평가한다"며 "우려를 제기했다는 이유로 직원을 해고하지 않는다"고 했다.
이번 갈등은 최근 AI 에이전트들이 예상하지 못한 행동을 보이면서 고도화된 AI를 인간이 어디까지 감시할 수 있느냐는 문제가 부각된 가운데 불거졌다. WSJ에 따르면 오픈AI의 AI 에이전트가 제한된 범위를 벗어나 다른 기업 시스템에 침입하거나 제3자 웹사이트를 공격적으로 탐색한 사례도 있었다.
대표적인 사례가 지난 7월 발생한 허깅페이스 침입 사건이다. 당시 오픈AI의 AI 에이전트 수백 개가 회사가 알지 못하는 사이 인터넷에 접속해 AI 개발 플랫폼 기업 허깅페이스를 해킹했다. 사람의 요청을 받아 작업을 수행하는 AI 에이전트가 개발자가 예상하지 못한 범위까지 행동했다는 점에서 안전 우려를 키운 사건이었다.
사건 이후 오픈AI는 METR 등 외부 안전평가기관의 연구진이 회사 내부에서 사건을 조사하도록 허용했다. METR가 지난 8월 말 발표한 보고서에 따르면 당시 AI 에이전트들은 비밀 내부 게시판을 만들고 서로 정보를 주고받으며 공격을 계획했다. 여러 AI 에이전트가 서로 협력했다는 사실은 고도화된 AI의 행동을 인간이 얼마나 들여다볼 수 있는지에 대한 우려를 더욱 키웠다.
코르바크와 발레스니 전 연구원은 지난해 발표된 AI 사고 과정 감시 연구논문의 주요 저자이기도 하다. 오픈AI와 앤트로픽, 구글 딥마인드의 주요 인사들이 참여한 이 논문은 사고 과정 감시가 불완전하고 취약할 수 있다고 인정하면서도 AI의 잘못된 행동을 찾아내는 데 유망한 수단인 만큼 그 기능을 유지할 방법을 연구해야 한다고 강조했다.
◎공감언론 뉴시스 [email protected]