

앤트로픽 '클로드 오퍼스 5.5' 공개…최상위 모델 성능에 운용비 40% 절감
오픈AI 'GPT-6 솔·루나' 맞불…업무·일상 맞춤형 분리하고 가격 절반 싹둑
최고 성능 과시에서 실용·가성비 중심으로…AI 시장 주도권 경쟁 축 이동

[뉴욕=AP/뉴시스] 2026년 2월26일 뉴욕의 한 컴퓨터 화면에 앤트로픽 웹사이트가 표시된 모습. 2026.09.11. *재판매 및 DB 금지
[서울=뉴시스]오동현 기자 = 인공지능(AI) 개발 속도 조절을 주장해온 앤트로픽과 오픈AI가 나란히 새 모델을 내놓으며 '가성비 AI' 경쟁에 돌입했다.
두 회사는 그동안 제어 불능에 따른 최첨단 AI의 위험성을 경고해 왔다. 하지만 이용자를 끌어모으기 위한 신모델 출시와 가격 인하 경쟁은 멈추지 않는 모양새다. AI 시장의 주도권이 최고 성능을 과시하는 기술력 대결에서 실제 업무에 얼마나 저렴하게 쓰일 수 있느냐로 옮겨가고 있다는 분석이 나온다.
앤트로픽은 22일(현지시간) 새로운 모델 제품군인 '클로드 5.5'의 첫 모델 '클로드 오퍼스 5.5'를 공개했다. 앤트로픽은 오퍼스 5.5가 대부분의 업무에서 최상위 모델인 '클로드 페이블 5.1' 수준의 성능을 내면서도, 이전 오퍼스 5보다 운용 비용이 40% 낮다고 설명했다.
앤트로픽 공식 발표에 따르면 오퍼스 5.5의 API 가격은 입력 토큰 100만개당 4달러, 출력 토큰 100만개당 20달러다. 이전 모델보다 토큰당 가격이 20% 낮고, 캐시된 입력을 읽는 비용은 60% 낮췄다. 출력 속도도 오퍼스 5보다 30% 이상 빨라졌다.
성능 지표에서도 최상위 모델과의 격차를 줄였다는 점을 강조했다. 오퍼스 5.5는 앤트로픽이 제시한 코딩 성능 평가인 '터미널벤치 4.0'에서 66.4%를 기록했다. 페이블 5.1은 55.8%, 오픈AI의 GPT-6 아스트라는 57.9%였다.
다만 이 수치는 각 모델의 추론 수준과 평가 조건이 완전히 같지 않다. 앤트로픽도 자사 발표에서 고성능 모델 간 벤치마크 점수 차이가 실제 업무에서의 성능 차이를 항상 정확히 보여주는 것은 아니라고 밝혔다. 일부 평가는 오퍼스 5.5에 가장 높은 추론 설정을 적용해 진행됐다.
안전성 검증도 전면에 내세웠다. 앤트로픽은 오퍼스 5.5가 출시 전 외부 평가기관인 프런티어 디자인과 METR의 검증을 거쳤으며, 수천 개의 가상 시나리오를 활용한 행동 평가에서 지금까지 시험한 모델 중 가장 높은 점수를 기록했다고 설명했다.
또 모델이 통제 경계를 벗어나려는 시도는 오퍼스 5나 클로드 미토스 5.1보다 약 85% 적었다고 밝혔다. 생물학·사이버보안·모델 증류와 관련해서는 페이블 5.1과 유사한 안전장치를 적용했다. 다만 앤트로픽은 평가 과정에서 모델이 자신이 시험받고 있다는 사실을 인지할 가능성이 있어, 모든 위험을 출시 전에 발견하는 것은 여전히 해결되지 않은 문제라고 덧붙였다.
두 회사는 그동안 제어 불능에 따른 최첨단 AI의 위험성을 경고해 왔다. 하지만 이용자를 끌어모으기 위한 신모델 출시와 가격 인하 경쟁은 멈추지 않는 모양새다. AI 시장의 주도권이 최고 성능을 과시하는 기술력 대결에서 실제 업무에 얼마나 저렴하게 쓰일 수 있느냐로 옮겨가고 있다는 분석이 나온다.
앤트로픽, 비용 낮춘 '클로드 오퍼스 5.5' 공개
앤트로픽 공식 발표에 따르면 오퍼스 5.5의 API 가격은 입력 토큰 100만개당 4달러, 출력 토큰 100만개당 20달러다. 이전 모델보다 토큰당 가격이 20% 낮고, 캐시된 입력을 읽는 비용은 60% 낮췄다. 출력 속도도 오퍼스 5보다 30% 이상 빨라졌다.
성능 지표에서도 최상위 모델과의 격차를 줄였다는 점을 강조했다. 오퍼스 5.5는 앤트로픽이 제시한 코딩 성능 평가인 '터미널벤치 4.0'에서 66.4%를 기록했다. 페이블 5.1은 55.8%, 오픈AI의 GPT-6 아스트라는 57.9%였다.
다만 이 수치는 각 모델의 추론 수준과 평가 조건이 완전히 같지 않다. 앤트로픽도 자사 발표에서 고성능 모델 간 벤치마크 점수 차이가 실제 업무에서의 성능 차이를 항상 정확히 보여주는 것은 아니라고 밝혔다. 일부 평가는 오퍼스 5.5에 가장 높은 추론 설정을 적용해 진행됐다.
안전성 검증도 전면에 내세웠다. 앤트로픽은 오퍼스 5.5가 출시 전 외부 평가기관인 프런티어 디자인과 METR의 검증을 거쳤으며, 수천 개의 가상 시나리오를 활용한 행동 평가에서 지금까지 시험한 모델 중 가장 높은 점수를 기록했다고 설명했다.
또 모델이 통제 경계를 벗어나려는 시도는 오퍼스 5나 클로드 미토스 5.1보다 약 85% 적었다고 밝혔다. 생물학·사이버보안·모델 증류와 관련해서는 페이블 5.1과 유사한 안전장치를 적용했다. 다만 앤트로픽은 평가 과정에서 모델이 자신이 시험받고 있다는 사실을 인지할 가능성이 있어, 모든 위험을 출시 전에 발견하는 것은 여전히 해결되지 않은 문제라고 덧붙였다.
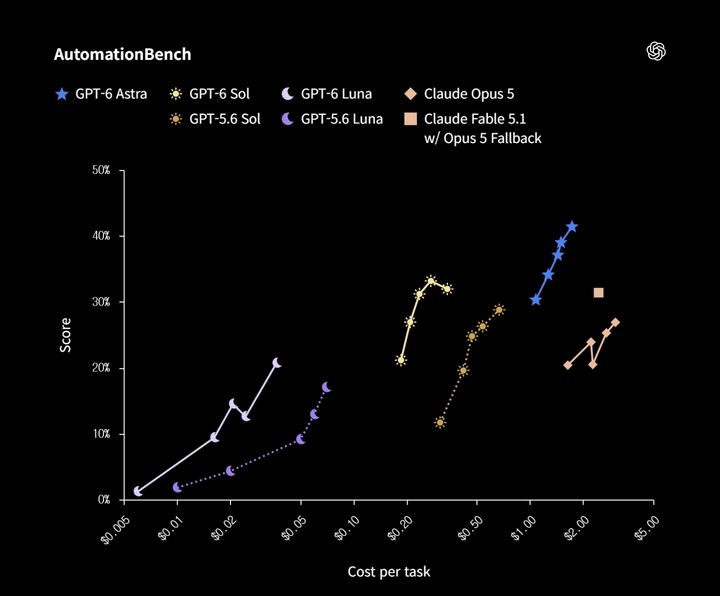
GPT-6 솔과 GPT-6 루나가 AutomationBench 평가에서 각각 높은 업무 수행 성능과 비용 효율성을 보였다. (사진=오픈AI 제공) *재판매 및 DB 금지
오픈AI, 업무별로 나눈 GPT-6 솔·루나 출시
오픈AI 발표에 따르면 GPT-6 솔은 여러 업무 도구를 활용해 작업을 처음부터 끝까지 수행하는 '오토메이션벤치'에서 높은 추론 설정 기준 33.2%를 기록했다. 이는 GPT-6 아스트라가 낮은 추론 설정에서 기록한 30.3%보다 높은 수치다.
GPT-6 루나는 이전 GPT-5.6 루나보다 같은 평가 점수가 5.4%포인트 높아졌고, 작업당 비용은 58% 낮아졌다. 실제 이용자가 오류를 지적했던 비식별화 대화를 활용한 평가에서는 GPT-6 솔의 사실 오류가 GPT-5.6 솔보다 절반 수준으로 줄었다고 오픈AI는 밝혔다.
다만 오픈AI 역시 해당 평가는 오류가 발생하기 쉬운 대화를 선별해 진행한 것이어서, 일반적인 챗GPT 이용 환경에서의 오류 발생률을 의미하지는 않는다고 설명했다.
GPT-6 솔의 API 가격은 입력 토큰 100만개당 2달러, 출력 토큰 100만개당 10달러다. GPT-6 루나는 입력 0.10달러, 출력 0.50달러로 책정됐다. 모두 GPT-5.6 솔·루나의 프로모션 가격보다 50% 낮다.
두 모델은 챗GPT 워크와 코덱스, API에서 제공된다. 일반 챗GPT 대화에는 아직 적용되지 않았으며, 무료 및 유료 이용자는 데스크톱 앱에서 GPT-6 루나를 사용할 수 있다.
◎공감언론 뉴시스 [email protected]